Gdy SCADA działa poprawnie, ale dane nie pracują na rzecz decyzji
Typowa sytuacja w zakładzie: dużo sygnałów, mało użytecznych wniosków
W większości dojrzałych zakładów przemysłowych systemy SCADA i sterowniki PLC wykonują swoje podstawowe zadania bez zarzutu. Zbierają tysiące parametrów na sekundę, sterują zaworami, napędami i grzałkami, wizualizują stan procesów na ekranach HMI oraz rejestrują tysiące wpisów w bazach historycznych. Problem pojawia się w momencie, gdy z tego ogromnego zbioru danych trzeba wyciągnąć wnioski wykraczające poza proste przekroczenie progu alarmowego.
Krótkie, kilkusekundowe zatrzymania linii produkcyjnej, mikroprzestoje, subtelne spadki wydajności czy nieznaczne dryfy parametrów jakościowych są rejestrowane jako pojedyncze, niezwiązane ze sobą zdarzenia. Działy utrzymania ruchu oraz inżynierowie procesu spędzają godziny na ręcznym przeglądaniu wykresów trendów w SCADA, próbując połączyć w całość odczyty z sensorów temperatury, drgań i poboru prądu. Dane w systemie są obecne, lecz pozostają pasywne – informują o skutkach, a nie o przyczynach i zależnościach między zmiennymi.
Próba analizy takich zależności za pomocą tradycyjnych narzędzi wbudowanych w SCADA szybko natrafia na barierę technologiczną. Klasyczne systemy wizualizacji nie zostały zaprojektowane do wykrywania wielowymiarowych wzorców w czasie rzeczywistym. W efekcie zakłady produkcyjne dysponują „górami danych”, z których codziennie wykorzystuje się jedynie ułamek, głównie do reaktywnego gaszenia pożarów po wystąpieniu awarii.
Dlaczego modyfikacja kodu PLC nie powinna być pierwszym krokiem
Niezwykle częstym błędem podczas próby wdrożenia zaawansowanej analityki jest chęć rozbudowy logiki bezpośrednio w sterownikach PLC. Inżynierowie wychodzą z założenia, że skoro dane powstają na poziomie sterownika, to tam najlepiej dokonać wstępnych przeliczeń, skomplikowanych filtracji czy wdrażania algorytmów predykcyjnych. Jest to podejście obarczone ogromnym ryzykiem operacyjnym i finansowym.
Sterownik PLC został zaprojektowany do realizowania deterministycznego cyklu programu, gdzie czas wykonania pętli mierzy się w milisekundach. Wprowadzenie do kodu sterownika złożonych operacji matematycznych, buforyzacji dużych tablic danych czy algorytmów statystycznych może wpłynąć na wydłużenie cyklu, a w skrajnych przypadkach doprowadzić do zatrzymania CPU. Co więcej, każda modyfikacja przetestowanego i zwalidowanego kodu w działającym zakładzie wymaga przestoju technologicznego, ponownych testów odbiorczych oraz niesie ryzyko wprowadzenia błędu w logice bezpieczeństwa lub sterowania procesem.
Utrzymanie takiego kodu staje się z czasem koszmarem inżynieryjnym. Logika sterowania miesza się z logiką analityczną, co utrudnia późniejsze modyfikacje maszyny. Zamiast tego znacznie bezpieczniejszym i bardziej elastycznym podejściem jest całkowite odseparowanie obliczeń analitycznych od warstwy wykonawczej. Kod sterownika pozostaje nienaruszoną podstawą działania maszyny, a cała złożona analityka wyższego poziomu odbywa się w dedykowanym środowisku zewnętrznym.
Granica odpowiedzialności
Najbezpieczniejszy podział ról jest prosty: PLC odpowiada za sterowanie i bezpieczeństwo procesu, SCADA za wizualizację oraz bieżącą obsługę operatorską, a platforma analityczna za przetwarzanie danych, wykrywanie wzorców i tworzenie rekomendacji. Każda z tych warstw ma inne wymagania dotyczące czasu odpowiedzi, dostępności i sposobu zmian. Sterownik musi działać przewidywalnie; model AI może być aktualizowany, porównywany z inną wersją lub czasowo wyłączony bez ingerencji w automatykę.
Takie rozdzielenie nie oznacza budowy równoległego systemu sterowania. Platforma AI powinna początkowo działać w trybie obserwacyjnym: odczytywać dane, oceniać ryzyko i prezentować wyniki operatorowi albo inżynierowi. Dopiero gdy organizacja ma jasno zdefiniowane zasady walidacji, odpowiedzialności i reakcji na rekomendacje, można rozważać przekazywanie wybranych sygnałów do systemów nadrzędnych. Nawet wtedy decyzja wykonawcza nie musi trafiać bezpośrednio do PLC.
To podejście ogranicza zakres zmian i upraszcza odbiór rozwiązania. Zamiast zatrzymywać linię, aby dopisać funkcje analityczne do programu sterownika, można podłączyć zewnętrzną warstwę przez istniejące interfejsy komunikacyjne, takie jak OPC UA, MQTT, API historyka lub bramka przemysłowa. Jeśli model nie przynosi oczekiwanej wartości, jego wyłączenie nie wpływa na działanie procesu. Jeśli działa dobrze, można rozwijać go niezależnie od cyklu życia programu PLC.
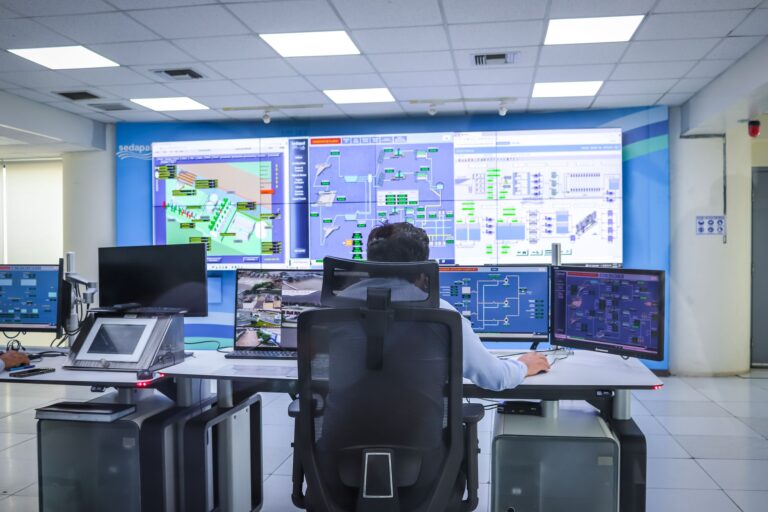
W praktyce granica odpowiedzialności chroni również ludzi. Operator nie otrzymuje „czarnej skrzynki”, która samodzielnie zmienia nastawy, lecz czytelną informację: rośnie prawdopodobieństwo problemu z napędem, jakość partii odbiega od typowego profilu albo sekwencja rozruchu przebiega inaczej niż zwykle. SCADA pozostaje miejscem kontroli procesu, natomiast AI staje się dodatkową warstwą interpretacji danych.
Największą korzyścią z takiej integracji jest możliwość rozwijania analityki bez naruszania stabilnego rdzenia automatyki. Zakład zachowuje deterministyczne sterowanie, a jednocześnie zyskuje przestrzeń do wykrywania zależności, których nie da się wygodnie opisać pojedynczym alarmem lub prostą regułą.
Architektura integracji bez dotykania logiki sterownika
Przepływ danych krok po kroku: od czujnika do chmury lub serwera edge
Podstawowym założeniem bezpiecznej integracji jest stworzenie równoległej ścieżki dla danych, która w żaden sposób nie obciąża procesora sterownika realizującego pętlę sterowania. Sygnał z czujnika fizycznego dociera do modułu wejść/wyjść PLC i trafia do jego pamięci operacyjnej. Stamtąd, zamiast dodawać w kodzie funkcje wysyłające dane do zewnętrznych systemów, wykorzystuje się wbudowane w infrastrukturę mechanizmy wymiany danych.
W praktycznym ujęciu przepływ danych architekturze nieinwazyjnej wygląda następująco:
- Odczyt pasywny z warstwy sterowania: Urządzenie brzegowe (Industrial Edge) lub oprogramowanie pośredniczące odczytuje wartości zmiennych z bufora sterownika bądź serwera OPC UA / historyka SCADA z częstotliwością dostosowaną do dynamiki procesu. Odczyt ten odbywa się w trybie reaktywnym lub subskrypcyjnym, bez generowania dodatkowych zadań po stronie pętli głównej PLC. [3]
- Buforowanie i filtracja lokalna: Zanim strumień danych opuści sieć operacyjną (OT), bramka brzegowa dokonuje wstępnej weryfikacji znaczników czasu, odrzuca wartości puste lub błędne oraz buforuje dane w przypadku chwilowej utraty łączności z warstwą analityczną.
- Przekazanie do magistrali danych: Ustrukturyzowany strumień trafia do brokera komunikatów lub dedykowanej bazy danych szeregów czasowych. Ta warstwa pełni funkcję łącznika – odciąża SCADA od bezpośrednich zapytań z zewnętrznych modeli AI.
- Przetwarzanie przez algorytmy: Platforma AI pobiera zestaw zmiennych z magistrali, generuje wnioski (np. wskaźnik anomalii, prognozę zużycia komponentu) i zapisuje je w swojej własnej bazie danych.
- Zwrotna prezentacja wniosków: Wyniki analizy wracają do operatora w postaci dedykowanego widoku, aplikacji webowej lub są przekazywane do SCADA jako dodatkowe tagi wizualizacyjne, które nie mają żadnego wpływu na automatykę wykonawczą.
Zapewnienie odizolowania sieci OT i bezpieczny odczyt
Najważniejszym elementem architektury z punktu widzenia inżynierów automatyki i cyberbezpieczeństwa jest zachowanie ścisłej separacji strefy OT od strefy IT/AI. Integracja analityki nie może tworzyć nowych wektorów ataku ani pozwalać na nieautoryzowane zapisy w pamięci sterowników.
Realizuje się to poprzez zastosowanie dedykowanych bramek przemysłowych wyposażonych w dwie fizycznie odseparowane karty sieciowe (dual-homed devices) lub zaporowych urządzeń sieciowych skonfigurowanych w trybie komunikacji jednokierunkowej. Podłączenie do sterownika lub serwera SCADA realizowane jest wyłącznie na koncie użytkownika z uprawnieniami typu „Read-Only” (tylko do odczytu). Nawet w przypadku całkowitego przejęcia kontroli nad platformą analityczną lub serwerem AI, system zewnętrzny nie ma fizycznej i logicznej możliwości przesłania komendy zapisu do rejestrów sterownika PLC.
Dane, które mają sens dla modeli AI — od tagów do kontekstu procesu
Surowe zmienne kontra kontekst operacyjny
Jedną z najczęstszych przyczyn niepowodzenia projektów łączących zaawansowaną analitykę ze środowiskiem SCADA jest przekazywanie do modeli AI „surowych” szeregów czasowych. Zmienna o nazwie `PT_204_VAL` generująca ciąg liczb float w skali czasu jest dla algorytmu uczenia maszynowego jedynie ciągiem punktów. Bez znajomości kontekstu technologicznego model nie wie, czy spadek wartości z 6 barów do 0 barów oznacza awarię pompy, czy też planowe zatrzymanie linii na czas przezbrajania.
Aby dane zyskały wartość analityczną, warstwa integracyjna musi przekształcić płaską listę tagów SCADA w bogaty strumień zdarzeń procesowych. Wymaga to wzbogacenia sygnałów fizycznych o metadane operacyjne:
- Stan pracy maszyny: Czy linia znajduje się w trybie produkcji, rozruchu, czyszczenia (CIP), czy w stanie postoju?
- Kontekst produktu: Jaki przepis, partia produkcyjna (Batch ID) oraz typ materiału są obecnie przetwarzane?
- Zdarzenia operatorskie: Czy zmiana wartości nastąpiła automatycznie, czy była wynikiem ręcznej korekty dokonanej na panelu HMI?
Metadane i standaryzacja: tworzenie jednolitej przestrzeni nazewniczej
W zakładach o złożonej strukturze architektonicznej, gdzie obok siebie pracują maszyny różnych producentów z różnymi generacjami sterowników, oznaczenia zmiennych bywają chaotyczne. W jednym systemie temperatura ciśnienia nazywa się `TEMP_BAR_1`, w innym `Sensor_Temp_C`. Wdrożenie analityki na skalę całego zakładu wymaga stworzenia ujednoliconej struktury danych (często opartej o architekturę Unified Namespace – UNS).
Konstrukcja ta porządkuje dane w logiczną hierarchię, odpowiadającą układowi fizycznemu zakładu (np. `Zakład / Obszar / Linia / Maszyna / Parametr`). Dopiero tak przygotowany model danych pozwala algorytmom AI porównywać wydajność i parametry pracy analogicznych urządzeń na różnych liniach, nie rozbijając się o różnice w nazewnictwie zmiennych w kodzie PLC.
Scenariusze AI, które można uruchomić obok SCADA
Detekcja wielowymiarowych anomalii w czasie rzeczywistym
Klasyczny system alarmowania w SCADA opiera się na sztywnych progach: jeśli temperatura przekroczy 85°C, wygeneruj alarm. Problem w tym, że awaria często nie następuje nagle, lecz jest poprzedzona subtelną zmianą relacji między wieloma zmiennymi, z których żadna pojedynczo nie przekracza dopuszczalnego limitu.
Model AI uruchomiony w warstwie zewnętrznej analizuje jednocześnie korelacje między drganiami, poborem prądu, temperaturą i przepływem. Jeśli przy stałym obciążeniu napędu rośnie jego temperatura i zmienia się widmo drgań, algorytm wykrywa anomalię na wiele dni przed tym, zanim klasyczny alarm SCADA zasygnalizuje przekroczenie krytycznego progu. Operator otrzymuje na osobnym ekranie ostrzeżenie z określeniem poziomu prawdopodobieństwa usterki i wskazaniem odchylających się parametrów.
Optymalizacja parametrów procesu i jakości partii
Innym scenariuszem jest wykorzystanie modeli AI do szukania idealnego okna technologicznego dla skomplikowanych procesów przetwórczych (np. mieszania, obróbki cieplnej, wytłaczania). Model uczenia maszynowego analizuje dane historyczne z uwzględnieniem czynników zewnętrznych – takich jak wilgotność otoczenia, temperatura surowca czy partia dostarczonego materiału.
W trakcie trwania procesu system analizuje bieżący przebieg parametrów i wyświetla operatorowi rekomendacje dotyczące optymalnych nastaw (np. podpowiedź dotycząca korekty prędkości dozowania lub temperatury strefy). Sug
gerowane korekty trafiają do interfejsu analitycznego jako podpowiedź dla technologa, a nie samowolna komenda dla sterownika. Zamiast wprowadzać skomplikowane algorytmy regulacyjne do pamięci PLC, cała ciężka analityka odbywa się w warstwie zewnętrznej, pozostawiając sprawdzoną logikę wykonawczą bez zmian.
Praktyczne decyzje i organizacja wdrożenia w zakładzie
Wprowadzenie zaawansowanej analityki obok istniejącego systemu SCADA wymaga spójnego podejmowania decyzji na styku dwóch środowisk: automatyki przemysłowej (OT) oraz inżynierii danych (IT). Aby wdrożenie przebiegło bez zakłóceń w ciągowym cyklu produkcyjnym, warto podzielić proces na czytelne etapy decyzyjne:
- Wybór pilotażowego obszaru: Najlepsze rezultaty przynosi rozpoczęcie prac od pojedynczej linii lub maszyny o wysokim wskaźniku awaryjności bądź dużej zmienności jakościowej, zamiast natychmiastowej integracji całego zakładu.
- Audyt dostępności danych i interfejsów: Zespół OT weryfikuje, które zmienne są już dostępne w serwerze OPC UA lub historyku, a gdzie konieczne jest dołożenie niezależnych czujników brzegowych bez wpinania się w pętlę sterowania.
- Określenie kryteriów sukcesu dla modeli: Zespół analityczny definiuje, jak mierzyć skuteczność (np. wyprzedzenie detekcji anomalii o określony czas, redukcja odrzutów produkcyjnych) w trybie czysto obserwacyjnym.
Różne grupy odbiorców w organizacji czerpią z tego modelu inne korzyści:
- Inżynierowie automatyki: Zyskują pewność, że żaden zewnętrzny proces nie spowolni cyklu sterowników i nie wywoła nieprzewidzianych stanów nieustalonych w kodzie PLC.
- Technolodzy i operatorzy: Otrzymują wsparcie w postaci sugerowanych nastaw, co pomaga utrzymać stałą jakość wyrobów bez konieczności ręcznego porównywania dziesiątek wykresów.
- Służby utrzymania ruchu: Przechodzą od reaktywnego usuwania usterek do przewidywania awarii na podstawie obiektywnych wskaźników generowanych przez algorytmy.
Bezpieczne połączenie tradycyjnego środowiska SCADA z nowoczesnymi platformami AI nie wymaga rewolucji w kodzie sterowników. Decyzja o odseparowaniu analityki od warstwy wykonawczej pozwala budować cyfrową infrastrukturę przy zachowaniu pełnej stabilności procesów technologicznych i niezmiennej kontroli operatora nad pracą maszyn.
Tryb obserwacyjny przed przekazaniem rekomendacji do użytkowników
Model analityczny nie powinien od razu wpływać na sposób prowadzenia procesu, nawet jeżeli technicznie jest odseparowany od PLC. Bezpieczniejszym podejściem jest uruchomienie go najpierw w trybie obserwacyjnym. Algorytm analizuje dane rzeczywiste, tworzy prognozy i oznacza odchylenia, ale jego wyniki nie są jeszcze wykorzystywane do podejmowania decyzji operacyjnych.
Ten etap pozwala porównać rekomendacje modelu z faktycznym przebiegiem produkcji, wpisami z dziennika zmianowego oraz zdarzeniami utrzymania ruchu. Jeżeli system wskazuje ryzyko awarii napędu, można po czasie sprawdzić, czy wystąpiło rzeczywiste pogorszenie jego stanu, planowany postój albo czynność serwisowa. Takie porównanie jest istotniejsze niż sama wysoka ocena modelu w środowisku testowym, ponieważ dane produkcyjne niemal zawsze zawierają wyjątki, braki i zmiany warunków pracy.
Dopiero po potwierdzeniu użyteczności wyników analityka może zostać udostępniona szerszej grupie użytkowników. W praktyce dobrze sprawdza się stopniowanie komunikatów: najpierw ekran diagnostyczny dla inżyniera procesu, następnie ostrzeżenie dla utrzymania ruchu, a dopiero później czytelna podpowiedź w widoku operatorskim. Nie każdy sygnał wykryty przez model powinien trafiać bezpośrednio do operatora, ponieważ nadmiar powiadomień szybko prowadzi do zjawiska zmęczenia alarmami.
AI nie zastępuje alarmów SCADA
Alarmy procesowe i predykcje generowane przez AI pełnią odmienne funkcje. Alarm SCADA ma chronić proces, maszynę lub ludzi w chwili, gdy przekroczony został ustalony warunek technologiczny. Musi być jednoznaczny, deterministyczny i powiązany z procedurą reakcji. Model AI działa inaczej: ocenia wzorzec zachowania, stopień odchylenia albo prawdopodobieństwo problemu, często zanim pojawi się stan alarmowy.
Łączenie obu mechanizmów w jeden system bez rozróżnienia ich ról może prowadzić do nieporozumień. Wynik modelu „podwyższone ryzyko uszkodzenia” nie jest tym samym co alarm zabezpieczający napęd. Nie powinien więc automatycznie wywoływać zatrzymania urządzenia ani być traktowany jak sygnał bezpieczeństwa funkcjonalnego. Jego zadaniem jest skierowanie uwagi człowieka na obszar wymagający sprawdzenia: łożysko, układ chłodzenia, jakość surowca czy stabilność nastaw.
Najczytelniejszy podział wygląda następująco:
- SCADA i PLC: realizują sterowanie, blokady, alarmowanie procesowe oraz działania wymagające przewidywalnej reakcji w określonym czasie.
- Historyk i warstwa danych: przechowują wiarygodny zapis przebiegu procesu, zdarzeń i stanów urządzeń.
- Platforma AI: wyszukuje zależności, klasyfikuje nietypowe zachowania, prognozuje trendy i przedstawia rekomendacje.
- Człowiek: interpretuje wynik w kontekście produkcji, potwierdza zasadność działania i zachowuje odpowiedzialność za decyzję operacyjną.
Taki układ jest szczególnie użyteczny tam, gdzie produkcja obejmuje częste zmiany asortymentu lub receptur. Model może rozpoznać, że dana kombinacja temperatury, czasu i obciążenia była historycznie związana z pogorszeniem jakości, lecz technolog nadal ocenia, czy w bieżącej partii występują warunki uzasadniające korektę.
Utrzymanie modeli: równie ważne jak ich wdrożenie
Połączenie SCADA z platformą AI nie kończy się w chwili uruchomienia przepływu danych. Z czasem zmienia się park maszynowy, receptury, dostawcy materiałów, sposób oznaczania partii i konfiguracja tagów. Model uczony na danych sprzed modernizacji linii może zacząć błędnie interpretować nowy, prawidłowy sposób pracy urządzenia. To zjawisko określa się jako dryf danych lub dryf modelu.
Dlatego warstwa analityczna wymaga regularnej kontroli jakości danych i wyników. Nie oznacza to konieczności ciągłego przebudowywania modeli, lecz ustalenia odpowiedzialności za kilka praktycznych czynności: monitorowanie braków w danych, wykrywanie zmian jednostek lub zakresów pomiarowych, weryfikację skuteczności predykcji oraz aktualizację słownika metadanych. [2]
Przydatne jest również wersjonowanie modeli i konfiguracji integracji. Gdy po zmianie oprogramowania SCADA albo modernizacji czujnika wyniki analizy nagle stają się niejednoznaczne, zespół powinien móc ustalić, jaka wersja modelu pracowała, z jakich tagów korzystała i jakie przekształcenia wykonano po drodze. W środowisku przemysłowym taka przejrzystość jest często ważniejsza niż zastosowanie najbardziej złożonego algorytmu.
Jak dobrać poziom integracji do dojrzałości zakładu
Nie każdy zakład potrzebuje od razu pełnej platformy danych, rozbudowanego Unified Namespace i modeli działających w czasie zbliżonym do rzeczywistego. Wybór architektury powinien zależeć od jakości dostępnych danych, krytyczności procesu oraz tego, kto będzie korzystał z wyników.
Jeśli celem jest analiza przyczyn odrzutów lub porównanie partii, wystarczający może być okresowy eksport danych z historyka do odrębnej platformy analitycznej. To podejście jest mniej złożone i dobrze nadaje się do analiz technologicznych, ale nie zapewnia szybkiego ostrzegania. Gdy potrzebne jest przewidywanie awarii lub bieżące wykrywanie odchyleń, lepsza będzie integracja oparta na subskrypcji danych z OPC UA, MQTT albo innego kontrolowanego kanału komunikacyjnego.
Największe wymagania stawia analityka wspierająca decyzje w trakcie procesu. W takim przypadku konieczne są nie tylko aktualne dane, lecz także konsekwentne znaczniki czasu, informacja o stanie pracy maszyny i jasne zasady prezentacji wyniku. Zbyt szybkie wdrożenie zaawansowanego modelu na nieuporządkowanych tagach zwykle daje słabszy efekt niż prostszy algorytm oparty na dobrze opisanych danych.
Najbardziej trwały model integracji opiera się więc na jasnym podziale odpowiedzialności: sterownik zachowuje kontrolę nad automatyką, SCADA pozostaje wiarygodnym narzędziem nadzoru, a AI dostarcza dodatkową warstwę interpretacji. Dzięki temu zakład może rozwijać predykcję, analitykę jakościową i optymalizację procesu bez ryzykownej ingerencji w sprawdzoną logikę PLC oraz bez odbierania operatorom kontroli nad maszynami. [1]
Najczęściej zadawane pytania (FAQ)
Czy integracja AI z SCADA wymaga modyfikacji programu PLC?
Nie. Analitykę można odseparować od sterownika i korzystać z istniejących interfejsów, takich jak OPC UA, MQTT, API historyka SCADA lub bramka przemysłowa.
Jaką rolę pełni PLC w architekturze z AI?
PLC nadal odpowiada za sterowanie i bezpieczeństwo procesu. Platforma AI analizuje dane, wykrywa wzorce i przygotowuje rekomendacje, nie przejmując bezpośrednio funkcji wykonawczych.
Czy platforma analityczna może automatycznie zmieniać nastawy sterownika?
Bezpieczna architektura powinna początkowo działać w trybie obserwacyjnym, a odczyt danych powinien odbywać się z uprawnieniami tylko do odczytu. Ewentualne dalsze działania wymagają jasno określonych zasad walidacji i odpowiedzialności.
Dlaczego same surowe dane z tagów SCADA mogą nie wystarczyć?
Bez kontekstu, takiego jak tryb pracy maszyny, partia produktu czy zdarzenia operatorskie, model może nie rozróżnić awarii od planowanego zatrzymania lub zmiany procesu.
Gdzie najlepiej uruchomić przetwarzanie danych?
Dane mogą być wstępnie buforowane i filtrowane na urządzeniu brzegowym, a następnie przekazywane do brokera komunikatów, bazy szeregów czasowych lub platformy analitycznej.
Kluczowe Wnioski
- Zaawansowaną analitykę można zintegrować z SCADA bez modyfikowania kodu sterowników PLC.
- PLC powinien zachować odpowiedzialność za deterministyczne sterowanie i bezpieczeństwo procesu.
- Platforma AI powinna początkowo działać w trybie obserwacyjnym, prezentując wyniki operatorom i inżynierom.
- Bezpieczna integracja wymaga odseparowania sieci OT od środowiska IT/AI oraz ograniczenia dostępu do odczytu.
- Modele AI potrzebują nie tylko surowych tagów, lecz także kontekstu operacyjnego i metadanych procesu.
Źródła
- [1] AVEVA – AVEVA PI System Portfolio ↑
- [2] AVEVA – AVEVA Predictive Analytics ↑
- [3] Inductive Automation – OPC UA Module | Ignition User Manual ↑